Datumaro는 Intel에서 Opensource로 배포하는 Dataset 관리를 위한 프레임 워크이다. Dataset 간의 변환 등의 다양한 기능을 제공하는데, 이를 이용하면 주어진 dataset이 어떤 포맷인지도 쉽게 알 수 있기에 유용하다. 이 포스팅에서는 Datumaro를 설정하고 dataset의 포맷을 확인하는 방법을 알아본다.
Dependencies
이 포스팅에서는 datumaro에 포함된 datum의 dataset download 기능을 이용해서 다양한 형식의 dataset을 download 받을 수 있었는데, 이를 이용하려면 다음의 의존성이 만족해야 한다.
pip install 'datumaro[tf,tfds]' \
   tensorboardX \
   tensorflow-dataset \
   importlib_resources \
   nibabel
tfds는 TensorFlow project에서 관리하는 dataset 컬렉션이고 여기에서 곧바로 다운로드를 받아 올 수 있다. 문서 상에는 Kaggle도 지원하는 것처럼 되어 있기는 한데, 실제로는 다운로드 되지 않았다(Jul 2026 현재).
Dataset Download
의존성 설치가 완료된 다음에는 datum 명령어를 이용해서 다운로드 가능한 dataset의 목록을 볼 수 있다.
datum download tfds describe --report-format json
위의 예제 명령줄은 tfds로 부터 목록을 받아오는 것이며 전술 했듯, 현재 시점에서 kaggle은 아무 내용도 보여 주지 않는다.
출력되는 결과에는 dataset의 이름과 그것에 대한 세부 사항들이 표시되는데, 특정한 dataset을 받기 위해서는 datum download의 get 명령어를 사용하면 된다. 예를 들어 다운로드 받은 항목이 다음과 같이 표시되었다고 하면,
{
  "tfds:cifar10": {
    "default_output_format": "cifar",
    "description": "The CIFAR-10 dataset consists of 60000 32x32 colour images in 10 classes, with 6000 images per class. There are 50000 training images and 10000 test images.",
    "download_size": 170052171,
    "home_url": "https://www.tensorflow.org/datasets/catalog/cifar10",
    "human_name": "CIFAR-10",
    "num_classes": 10,
    "version": "3.0.2",
    "subsets": {
      "train": {
        "num_items": 50000
      },
      "test": {
        "num_items": 10000
      }
    }
  },
...
}
이 데이터셋 “tfds:cifar10”을 다운로드 받기 위해 dataset의 id를 명시해서 다음의 명령어를 수행하면 된다.
mkdir -p ~/Downloads/dataset
datum download tfds get -i tfds:cifar10 -o ~/Downloads/dataset/cifar10
Dataset format detection 예제
특정한 dataset의 형식을 알고자 한다면 datumaro.Dataset.detect() method의 path parameter에 dataset의 root directory를 넘겨주면 어떤 형식인지 str로 반환해 준다.
내 경우, dataset을 압축 포맷으로 저장해 두는 경우가 많아서, 압축파일을 임시 디렉토리에 풀고 해당 dataset의 format을 검사해서 출력하도록 작성했다.
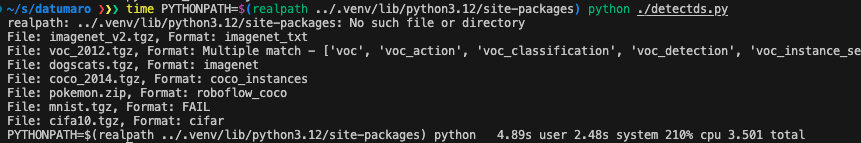
실행결과
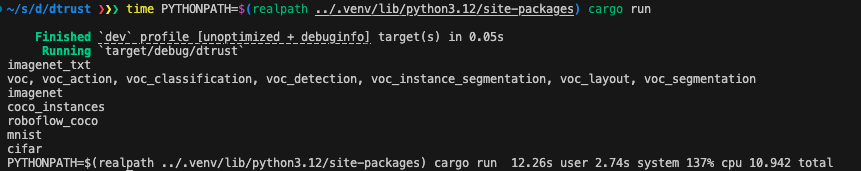
현재 다운로드가 가능한 tfds의 모든 format들과 내가 가지고 있던 dataset들의 format을 잘 detect 해 주었다. 다만, voc_2012 dataset은 하나 이상의 format으로 매치 되는 MultipleFormatsMatchError가 올려지고 있어서 이 경우에 대한 부가적인 처리가 필요할 것 같다. 예제 에서는 그냥 중복 매칭된 포맷들의 목록을 출력해 주었다.