태그 보관물: lightsail

Ligthtsail 하위 인스턴스로 되돌리기

올해 초 워드프레스를 마이그레이션 하는 중에 메모리 문제로 잠깐 상위 인스턴스로 갔다가 되돌아 오겠다는 계획을 했던 적이 있었다. 계획은 그럴 듯 한것 같았으나 “Lightsail 스냅샷으로 하위 인스턴스를 생성할 수 없다“는 사실만 깨닫고 울며 겨자 먹기로 5개월 가량을 비싼 인스턴스를 써왔다.

야, 그런데 이거 정말 안되는 거 맞아?

Gemini에게 물어보니 “안될리가 있겠습니까요”라며 그럴 듯한 마이그레이션 계획은 새워준다. 인스턴스 생성 후에 일일이 설정했던 것들을 알려주면서 이것들도 모두 꼬옥 포함되어야 한다고 당부를 했더니 자기가 bash script로 만들어 줄테니 실행만 하면된다며 backup용 script와 복구용 script를 만들어 쥐어주었다.

Back up script
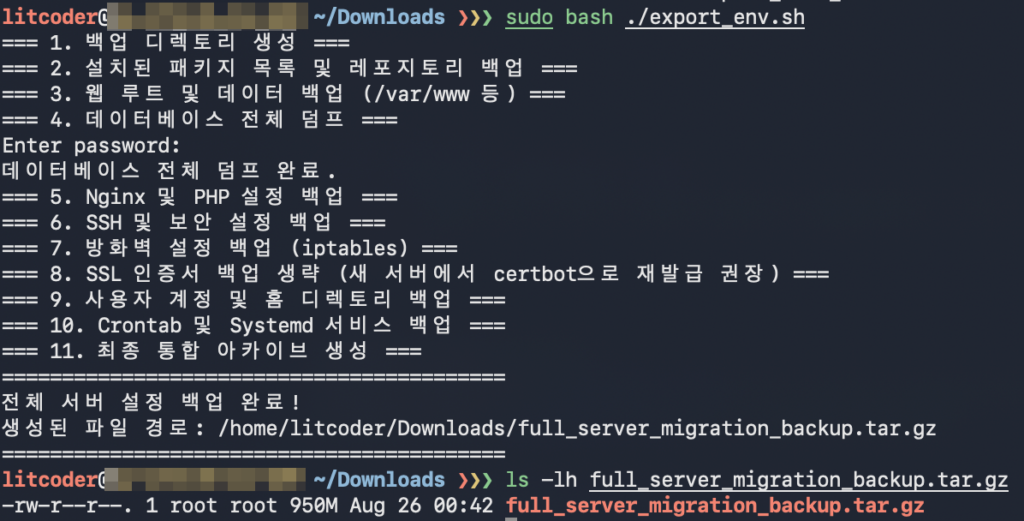
서버 인증서는 백업하기 보다는 재발급 받는게 나을것 같다고 해서 이것을 제외하고 다른 모든 것들을 백업하는 스크립트를 돌려서 만들어진 파일은 크기가 무려 950MB짜리 초대형 슈퍼 울트라 원 클릭 “full_server_migration_backup.tar.gz”이다.

Restore script

이제 가격이 싼 인스턴스를 생성하고 만들어진 백업 파일과 복원 스크립트를 옮기고 복원 script를 실행시켰더니… 적용하는 중에 EOF 에러가 여기저기에서 떨어지면서 뭔가 동작이 조금 이상했다. 마지막 단계에서는 인증서까지 새로 발급 받으려고 하길래 아직 도메인이 적용되지 않았으니 기다리라고 취소를 눌렀다.

후 폭풍과 뒷 수습

자신감 넘치는 AI들의 속삭임에 속은 게 한 두번이 아니기는 하지만 결과물을 보고는 다시 한 번 놀랄 수 밖에 없었다. 복원했다던 wordpress 폴더는 깔끔하게 비워져 있고 설정된 것이라고는 nginx과 database 그리고 php 환경 정도였다. 실제로는 복원 스크립트라기 보다는 LEMP 설치용 스크립트에 가까웠던 것이다.

wordpress 수동복사

그나마 database는 복원이 되어 있었기 때문에 이전 서버의 /var/www/html/ 경로에 있던 WordPress 파일들을 모두 복사해서 새로운 서버에 올려 주었다.

WordPress 설정파일 임시 설정

백업된 /etc/nginx/conf.d/wordpress.conf에는 HTTPS 관련한 설정이 들어가 있는데, 아직 cert. 업데이트를 하지 않은 상태에서는 이상 동작 하기 때문에 해당 파일을 80번에서 HTTP만 대기 하도록 간단히 임시로 수정한다. 물론 이전 설정 파일은 결국 사용할 것이니까 버리지 않고 백업해 두었다.

Certificate update

사실 인증서 업데이트 항목이 복원용 스크립트에 들어가 있다는게 말이 안된다. Cert update를 한다는 건 도메인을 연결한 상태라는 건데 아직 설정중인 서비스가 어떻게 동작할 지도 모르는 걸 도메인 부터 연결 한다는게 AI 급의 엄청난 자신감이 아니라면 안될말이다.

먼저 HTTP로 서비스가 잘 동작하고 기본적인 복원이 된 것을 확인하고, 그 다음에 도메인을 새로운 인스턴스로 연결해 준 뒤에 certbot을 실행시켜서 인증서를 수동으로 업데이트 했다. Lightsail 인스턴스 페이지에서 HTTPS용 443번 포트를 사용할 수 있도록 방화벽 잊지 않고.

WordPress 설정파일 복원

HTTPS를 위한 인증서를 업데이트 했으니 앞서 백업해 두었던 임시파일을 복원하고 nginx를 재실행 해준다.

Redis설치

Redis에 대한 내용이 백업과 복원에서 완전히 빠져 있어서 웹사이트가 실행되지 못하고 있었다. Redis를 설치하고 실행해 주었다.

Imagick 설치와 메모리 부족

이제 WordPress의 건강상태 화면을 확인했더니 php-pecl-imagick 모듈이 설치되지 않아서 건강하지 못한 상태라고 한다. 문제는 여기에서 터졌는데 512MB의 미약한 RAM 크기로는 이 패키지를 설치하는 중에 요구되는 메모리 피크를 감당하지 못하고 설치에 실패했다. 그러고 보니 애초에 비싼 인스턴스로 옮겨갔던 이유도 백업 프로그램 동작 중에 RAM 피크를 감당하지 못해서 문제가 생겼던 것인데 지금도 똑같은 문제가 생기고 있었다.

Swap 확장

“아! 그때는 왜 이생각을 못했을까.”

AI가 해결책이라고 알려준 이 방법은 사실 예전에 비싼 인스턴스로 옮기기 전에도 시도해 봤어야 했다. 현재 기본적으로 주어지는 400MB의 sawp에 추가로 1GB를 할당하고 설치를 재실행했더니, 시간이 좀 걸리기는 했어도 문제 없이 설치가 되었다. “비싼돈 쓰기 전에 swap 확장 부터!” 값진 교훈을 AI로 부터 의도치 않게 전수 받아 마음에 새겨둔다.

한가지 특이했던 점은 새로 만든 1GB swap 공간을 연결하기전에 swap off를 실행하지 않았더니 기존의 크기와 합쳐서 1.4GB의 swap이 인식되었다는 점이다. Swap 공간을 부팅 이후에도 계속 사용하도록 /etc/fstab에 추가해 두었다.

공격 대비

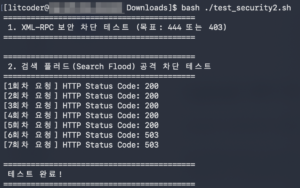
지난번에 “Lightsail 서버가 자꾸 죽어서” 확인했던 XMLRPC와 search flood attack에 대해 새 서버에 대비가 잘 되어 있는지 확인하는 스크립트를 만들어 달라고 했더니 뚝딱 만들어 주었는데 이것은 별 문제 없이 잘 돌려서 확인할 수 있었다.
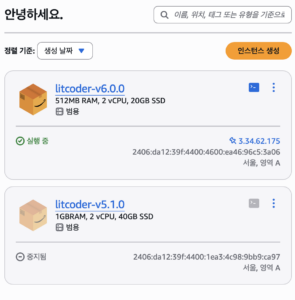
그 동안 수고 많았다 비싼 친구야

인스턴스에 변경이 있을 때 마다 올리던 버전이 이제는 어느새 6.0이 되었다. 새로운 인스턴스의 건강 상태와 동작을 최종 확인한 다음 1GB, 40GB 짜리 비쌌던 인스턴스는 이제 은퇴하고 다시 예전의 기본 tier로 돌아 오게 되었다.
MAPA: Make All Health-checks Pass Again

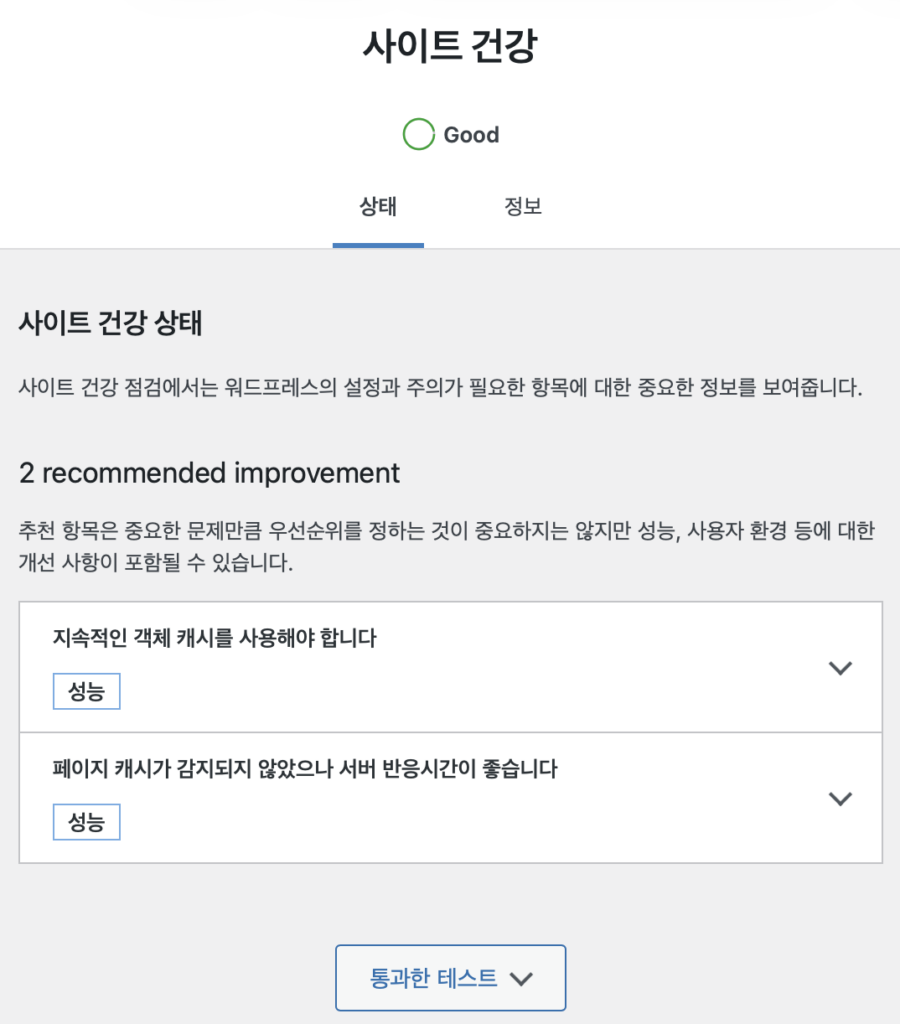
핸드폰에 떠 있는 알람 뱃지 조차도 모두 확인해야 직성이 풀리는 성격의 소유자에게 WordPress의 건강화면에서 항상 보이는 저 두개의 문제점들은 여간 눈에 거슬리는게 아니다. 특별히 기능에 별 문제가 없음에도 무언가 해야 할 것이 남은 듯한 찜찜함에 또 삽을 들었다.

건강문제 1: “지속적인 객체 캐시를 사용해야 합니다”

객체 캐시 서비스를 설정하지 않아서 보고되는 내용으로, Redis나 Memcached 같은 캐시 서비스를 설치해서 해결 할 수 있다. 다음의 명령어로 AL2023에서 Redis6를 설치해 준다.

sudo dnf install redis6 -y
sudo systemctl start redis6
sudo systemctl enable redis6 

그리고 나서 Redis6와 PHP가 소통할 수 있도록 php-redis도 설치해 준다.

sudo dnf install php-redis -y
sudo systemctl restart php-fpm

Redis6의 설정파일인 /etc/redis6/redis6.conf에 다음 두 줄을 추가해서 메모리 사용량은 128MB로 제한한다. 지금 사용하고 있는 plan의 메모리가 그다지 여유롭지는 않기 때문에 이정도 크기로 제한을 두었다.

maxmemory 128mb
maxmemory-policy allkeys-lru

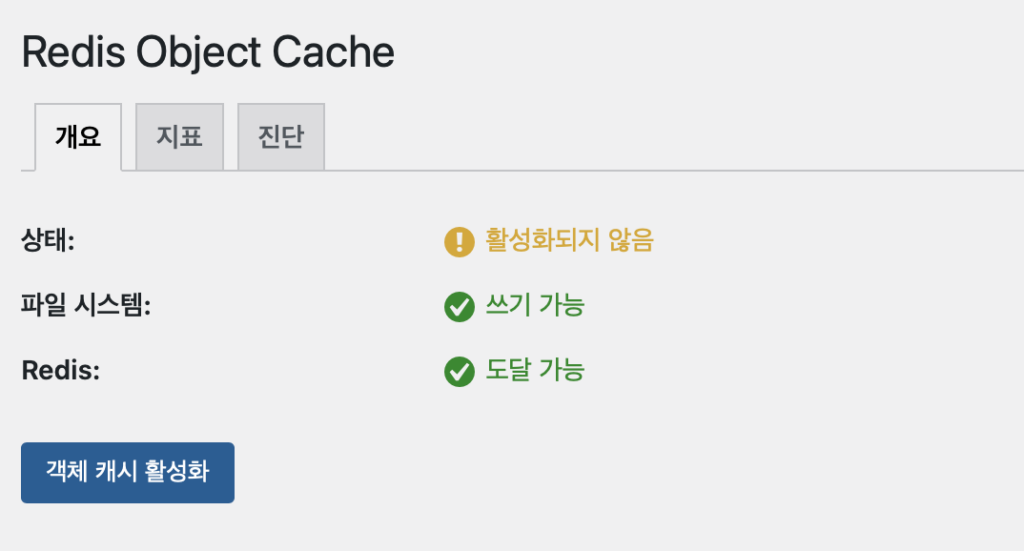
마지막으로 WordPress에서 Redis Object Cache plugin을 설치하고 활성화 시켜준다.

건강문제 2: “패이지 캐시가 감지되지 않았으나 서버 반응시간이 좋습니다”

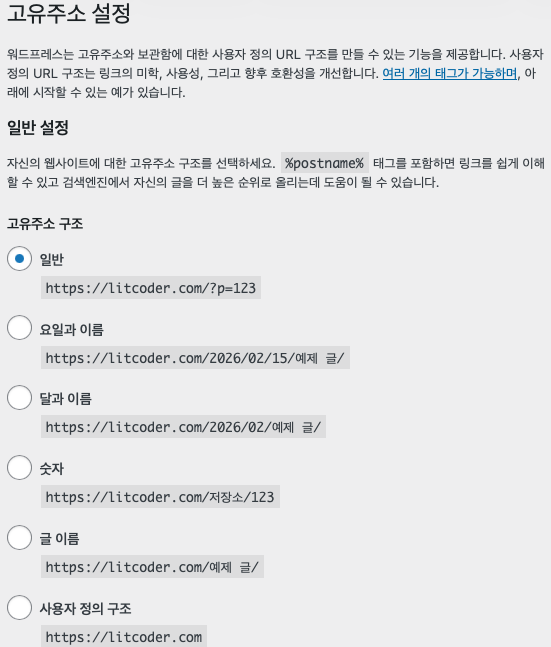
매번 페이지가 로드될 때마다 PHP process를 거치지 않아도 되도록 static cache를 설정해 달라는 내용이다. 아주 간단하게는 WordPress plugin을 설치해서 해결할 수도 있는데, 문제는 이러한 plugin들이 대부분 고유주소(permalink) 형식을 다른 것으로 변경하는 것을 요구한다는 것이다.

검색엔진의 상위에 뜨기 위해서라도 이 설정을 "글이름” 형식으로 설정하는게 좋다고는 하는데 검색엔진 상위에 뜨는 건 딱히 관심사도 아닌데다가 무엇보다도 저 형식은 별로 예쁘지 않다.

다행히도 Nginx에서 FastCGI caching을 설정하는 방법으로 static caching을 달성할 수 있다. 먼저 캐시로 사용할 공간을 만들어 준다.

sudo mkdir -p /var/run/nginx-cache
sudo chown nginx:nginx /var/run/nginx-cache
sudo chmod 700 /var/run/nginx-cache

Nginx의 전역 설정파일인 /etc/nginx/nginx.conf의 http 영역에 캐시의 경로와 메모리 사용량(10MB)을 정의한다.

fastcgi_cache_path /var/run/nginx-cache levels=1:2 keys_zone=wpcache:10m inactive=60m;
fastcgi_cache_key "$scheme$request_method$host$request_uri";

다음으로 server 영역에 관리자 페이지나 포스트 작성 처럼 캐시를 사용하지 않을 경우를 설정한다.

location ~ \.php$ {
...
    # Cache예외 경우 설정
    set $skip_cache 0;
    if ($query_string != "") { set $skip_cache 1; }
    if ($request_uri ~* "/wp-admin/|/xmlrpc.php|wp-.*.php|/feed/|index.php|sitemap(_index)?.xml") {
        set $skip_cache 1;
    }
    if ($http_cookie ~* "comment_author|wordpress_[a-f0-9]+|wp-postpass|wordpress_no_cache|wordpress_logged_in") {
        set $skip_cache 1;
    }
    
...
}

그리고 캐시 사용을 다음과 같이 설정한다. 아래의 "디버깅 목적"에 있는 헤더에 내용을 추가하는 부분은 굳이 넣지 않아도 되지만, WordPress의 건강검사 메뉴에서 캐시적용 여부를 판단하는 부분을 위해서 넣어 주었다. 이 부분을 추가해 주지 않으면 정적 캐시가 동작하고 있어도 캐시 관련 메세지가 계속 뜨게 된다.

location ~ \.php$ {
...
    # Cache
    fastcgi_cache wpcache;
    fastcgi_cache_valid 200 301 302 60m;
    fastcgi_cache_bypass $skip_cache;
    fastcgi_no_cache $skip_cache;
        
    # 캐시 적중 여부를 헤더에 표시 (디버깅 목적)
    add_header X-FastCGI-Cache $upstream_cache_status;
    add_header X-Cache-Enabled "True";  # 건강검사 통과용
    add_header X-Proxy-Cache $upstream_cache_status;
...
}

결과

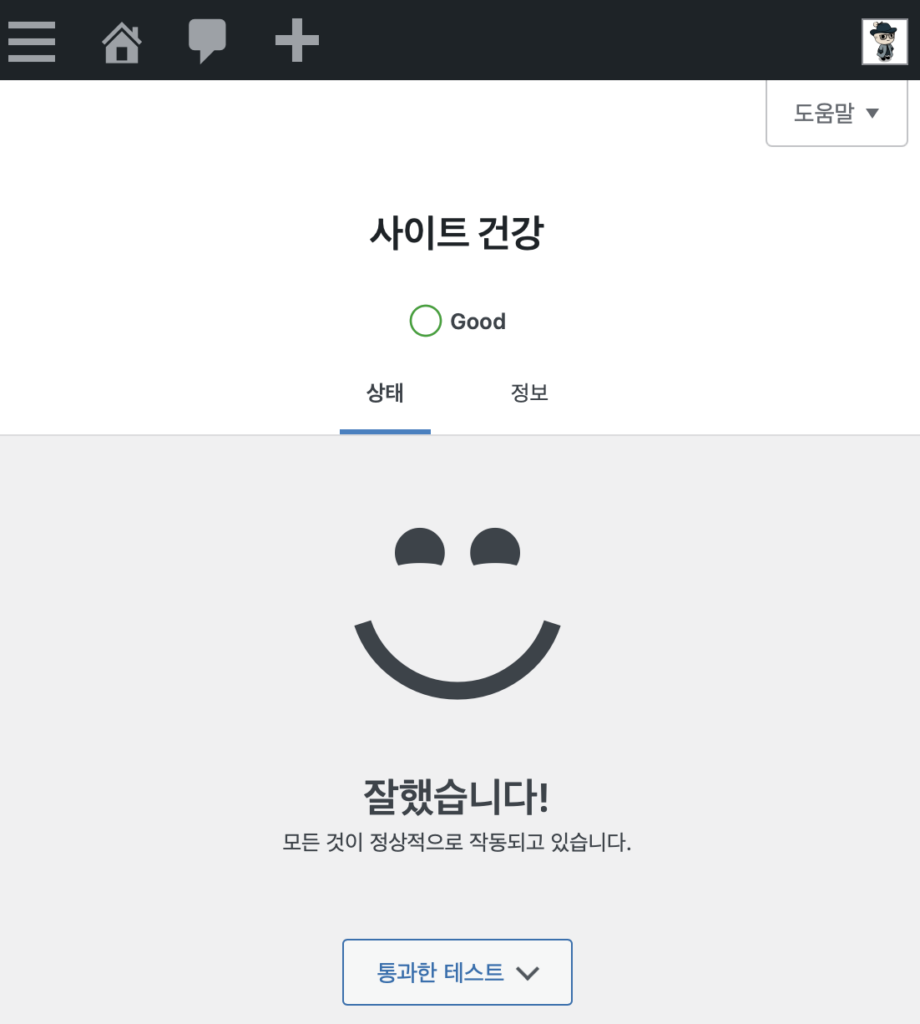
잘했다!

Lightsail 서버가 자꾸 죽어요

Jetpack이 요즘처럼 많이 말을 건 적이 있었던가?

최근에 Bitnami에서 Amazon Linux 2023으로 이사하면서 Lightsail instance를 한 단계 비싼 것으로 올리고 나서부터 웹사이트가 다운되었다는 Jetpack의 노티가 계속 뜬다.

더 비싸면 더 잘돌아야 되는 것 아닌가?

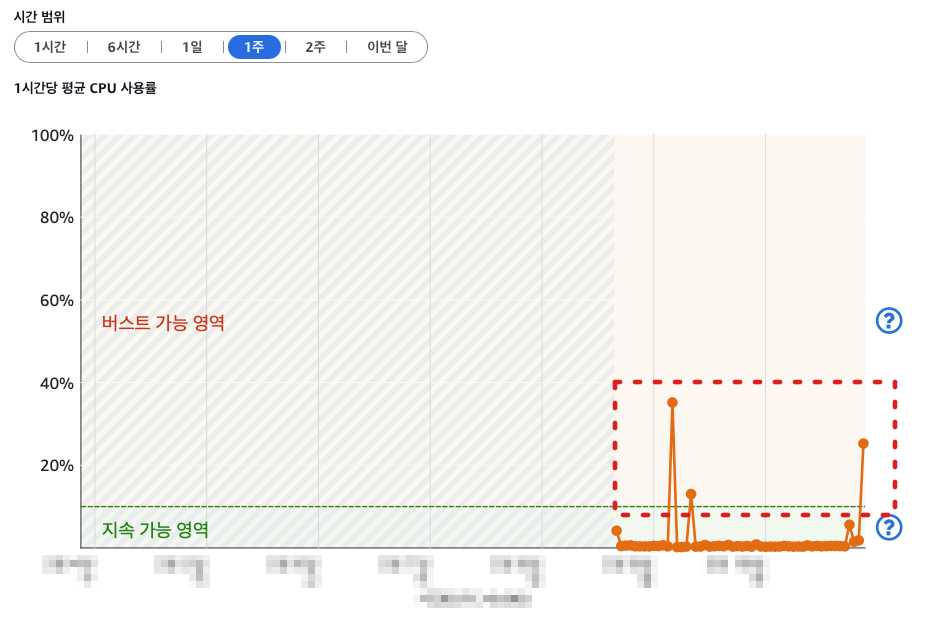
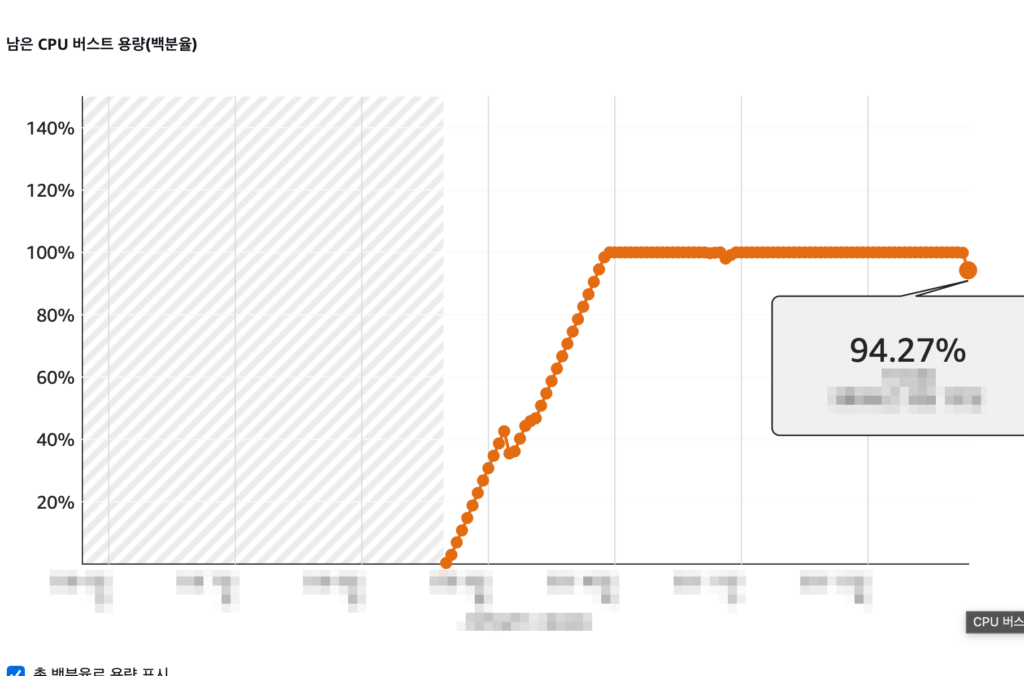
이런 노티를 받고나서 확인해 보면 블로그가 접속되지 않을 뿐만 아니라 SSH 조차도 뜨지 않는 상태가 되어 있어서 서버를 강제 재시작 하는 방법 밖에 없다. Lightsail의 Metrics 메뉴에서 확인해 보면 이때마다 CPU 사용률이 치솟고 있는 것도 보인다.

적습! – XML RPC

따로 cron task를 걸어 놓은 것도 없는데 이렇게 많은 CPU 자원이 소모되는 이유는 뭘까?

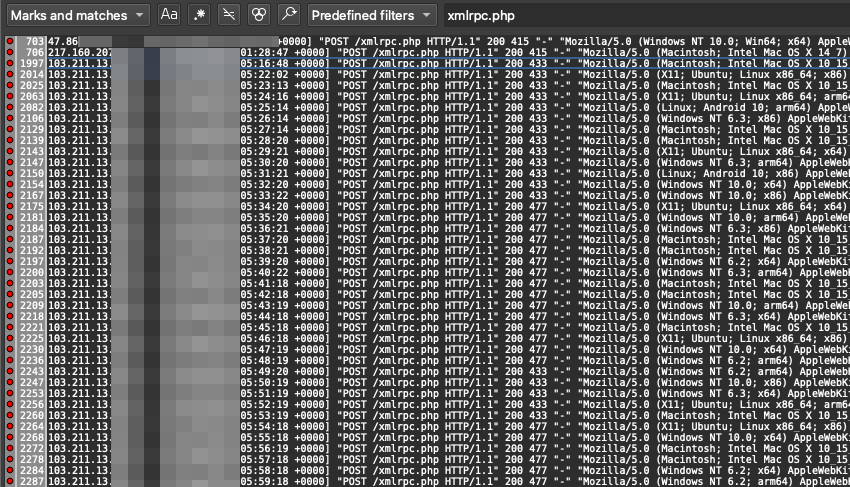
Nginx의 access log를 들여다 봤더니 짧은시간 동안에 한 IP에서 아주 많은 xmlrpc.php에 대한 접속시도가 있었다. XML RPC는 REST API로 대체되어 요즘에는 실제로 사용되는 경우가 거의 없는데, 공격자들은 system.multicall 기능을 활용해 다수의 비밀번호 무차별 대입 공격을 수행하는데 자주 쓴다고 한다.

xmlrpc를 막는 여러가지 방법이 있으나, WordPress에서 막지 않고 아예 Nginx에서 xmlrpc접속을 막아버리도록 다음과 같이 설정해 주었다.

# xmlrpc.php 차단
location = /xmlrpc.php {
    deny all;          # xmlrpc.php 접속을 차단
    access_log off;    # 접속 로그를 남기지 않아서 IO 자원을 아낌
    log_not_found off; # Not found(404) 로그도 남기지 않는다
    return 444;        # Nginx 비표준, 404 응답을 보내지 않고 연결을 끊어버림
}

두번째 적습! – Search Flood

이렇게 막고 나서 하루 정도는 잠잠했었는데, 바로 다음날 저녁에 다시 서버에 접속할 수 없다는 Jetpack의 알람이 왔다.

이번에도 CPU 사용량이 치솟으며 SSH접속도 안될 정도로 무언가를 엄청나게 하고 있었다. 분명히 xmlrpc는 막아 두었는데 이번엔 또 뭘까?

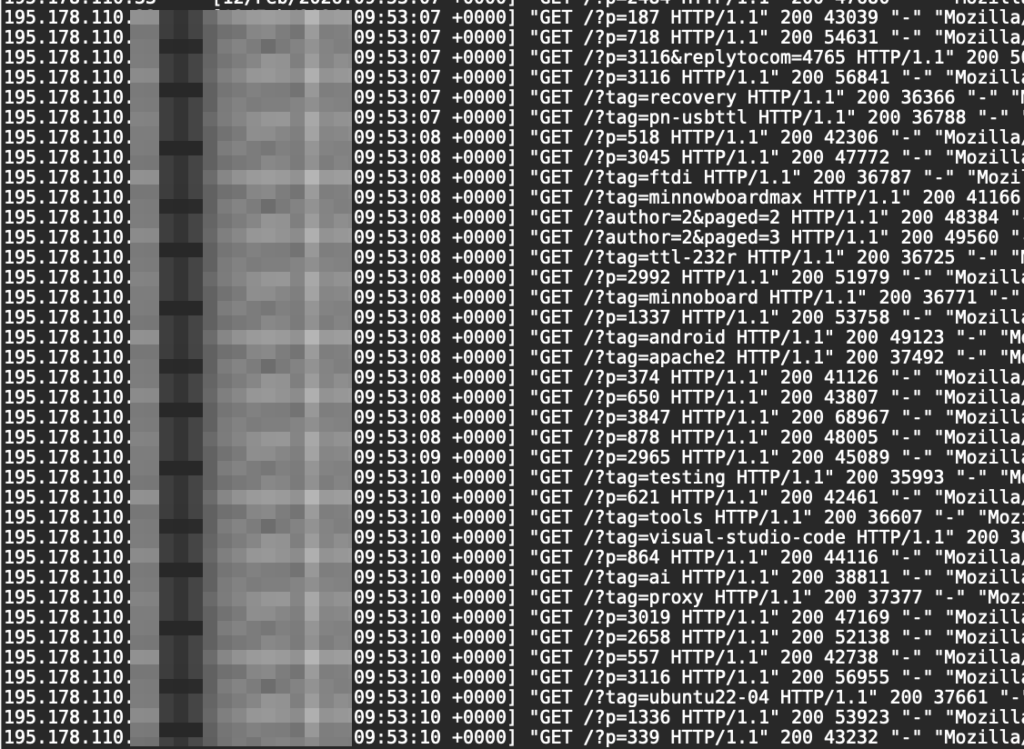
로그를 보니 이번에도 하나의 IP에서 짧은 시간동안에 태그, 검색어, 저자, 문서번호 등으로 엄청난 조회(GET) 요청을 받고 있었다. 이번 것은 XML RPC 공격때와 같이 로그인 비밀번호를 알아 내기 위한 것 보다는 서버에 많은 부하를 주어서 서비스를 방해하려는 목적인 것 같다.

외부에서 들어오는 조회가 진짜인지 가짜인지 확인하는 뾰족한 방법은 없고, 다만 너무 잦은 것이 문제가 되는 상황이니 Rate limiting을 걸어서 이런 경우를 걸러내기로 했다.

Nginx 설정파일을 변경해서 먼저 http 영역에서 비정상적인 검색을 시도하는 IP들을 추적하도록 설정한다.

http {
    ...

    # 검색을 요청하는 경우 IP를 저장해 둔다.
    map $arg_s $search_traffic {
        default "";              # 일반적인 접속, track안함.
        ~.+ $binary_remote_addr; # 검색요청하는 IP는 track.
    }

    # 분당 10회 이상의 검색 시도가 있으면 $search_traffic zone에 추가.
    limit_req_zone $search_traffic zone=search_block:10m rate=10r/m;
    ...
}

그리고 나서 server 영역에는 이러한 시도가 5번을 넘기면 차단하도록 다음과 같이 설정한다. 해당 IP는 Service Unavailable(503) 응답을 받게 될 것이다.

server {
    ...
    location / {
        # 5번까지의 burst시도까지는 허가.
        limit_req zone=search_block burst=5 nodelay;
    
        try_files $uri $uri/ /index.php$is_args$args;
    }
    ...
}

Swap 설정 추가

그리고 조금 놀라웠던 사실인데 AL2023 instance에는 기본적으로 swap 영역이 설정되어 있지 않았다. 서비스가 조금 느려지더라도 응답 못하는 일은 없도록 swap영역을 설정해 주었다. swap 설정하는 방법은 인터넷에 많으니 패스.

결론

Bitnami에서 설정해 준 것으로 안락하게 지내다가, 직접 서버를 설정하겠다고 나선지 며칠만에 무작위 공격들로 가득찬 인터넷을 겪고 보니 새삼 살벌한 세상이 실감된다.

하지만 그 덕에 다양한 공격 방법들과 설정 방법들에 대해 더 알게되니 재미있기도 하다. 상용서비스가 아니라서 문제가 생기면 재부팅이라도 할 수 있으니 그나마 다행이랄까.